

In sintesi
Quando si parla di Intelligenza Artificiale applicata all’Industrial IoT, il primo errore è pensare che esista un unico modello AI adatto a tutto. Non è così. Un impianto industriale intelligente non ha bisogno di un solo grande cervello centralizzato. Ha bisogno di una catena distribuita, dove ogni livello usa il modello giusto per il compito giusto. Il sensore deve rilevare. Il microcontrollore deve reagire.
Scenario e contesto
Quando si parla di Intelligenza Artificiale applicata all’Industrial IoT, il primo errore è pensare che esista un unico modello AI adatto a tutto.
Non è così.
Un impianto industriale intelligente non ha bisogno di un solo grande cervello centralizzato. Ha bisogno di una catena distribuita, dove ogni livello usa il modello giusto per il compito giusto.
Il sensore deve rilevare.
Il microcontrollore deve reagire.
Il gateway deve aggregare.
Il modello AI deve interpretare.
L’agente locale deve trasformare i dati in decisioni operative.
Questa è la vera differenza tra “mettere l’AI in fabbrica” e costruire un’architettura industriale realmente utile.
Perché l’AI industriale non può dipendere solo dal cloud
Nel mondo consumer siamo abituati a pensare all’AI come a qualcosa che vive nel cloud. Si invia una richiesta, un server remoto elabora, poi restituisce una risposta.
In fabbrica però il contesto è diverso.
I dati industriali possono essere sensibili. Possono riguardare efficienza produttiva, cicli macchina, consumi, anomalie, qualità, manutenzione, ricette di produzione o informazioni strategiche dell’azienda.
Mandare tutto nel cloud non è sempre accettabile.
Inoltre, un sistema industriale deve poter funzionare anche quando la connessione non è stabile. Deve ridurre la latenza. Deve restare sotto il controllo dell’azienda. Deve integrarsi con PLC, SCADA, database locali, sensori, gateway e sistemi esistenti.
Qui entra in gioco l’AI locale.
Non come sostituzione dei sistemi industriali certificati, ma come nuovo livello di analisi, interpretazione e supporto decisionale.
Primo livello: TinyML vicino alla macchina
Il primo livello è quello più vicino al mondo fisico.
Parliamo di microcontrollori, sensori intelligenti, ESP32, STM32, Arduino industriali, dispositivi embedded e piccole CPU dedicate.
Qui non ha senso parlare di grandi modelli linguistici. Nessuno dovrebbe pensare di far girare un LLM completo direttamente dentro un microcontrollore.
In questo livello entra in gioco il TinyML.
Il TinyML serve per eseguire piccoli modelli di machine learning direttamente su dispositivi con risorse molto limitate. Google descrive LiteRT for Microcontrollers come un runtime pensato per eseguire modelli di machine learning su microcontrollori e dispositivi con pochi kilobyte di memoria, senza sistema operativo, librerie standard C/C++ o allocazione dinamica della memoria.
Questo tipo di modello non deve “ragionare” in linguaggio naturale.
Deve rilevare.
Può riconoscere una vibrazione anomala, una temperatura fuori curva, un rumore diverso dal solito, un consumo irregolare, una micro-variazione ripetitiva nel comportamento di una macchina.
Il suo lavoro è semplice, veloce e locale.
Non spiega cosa sta succedendo.
Segnala che qualcosa merita attenzione.
Ed è proprio questa semplicità a renderlo prezioso.
Implicazioni operative
Secondo livello: edge gateway e modelli compatti
Il secondo livello è l’edge gateway.
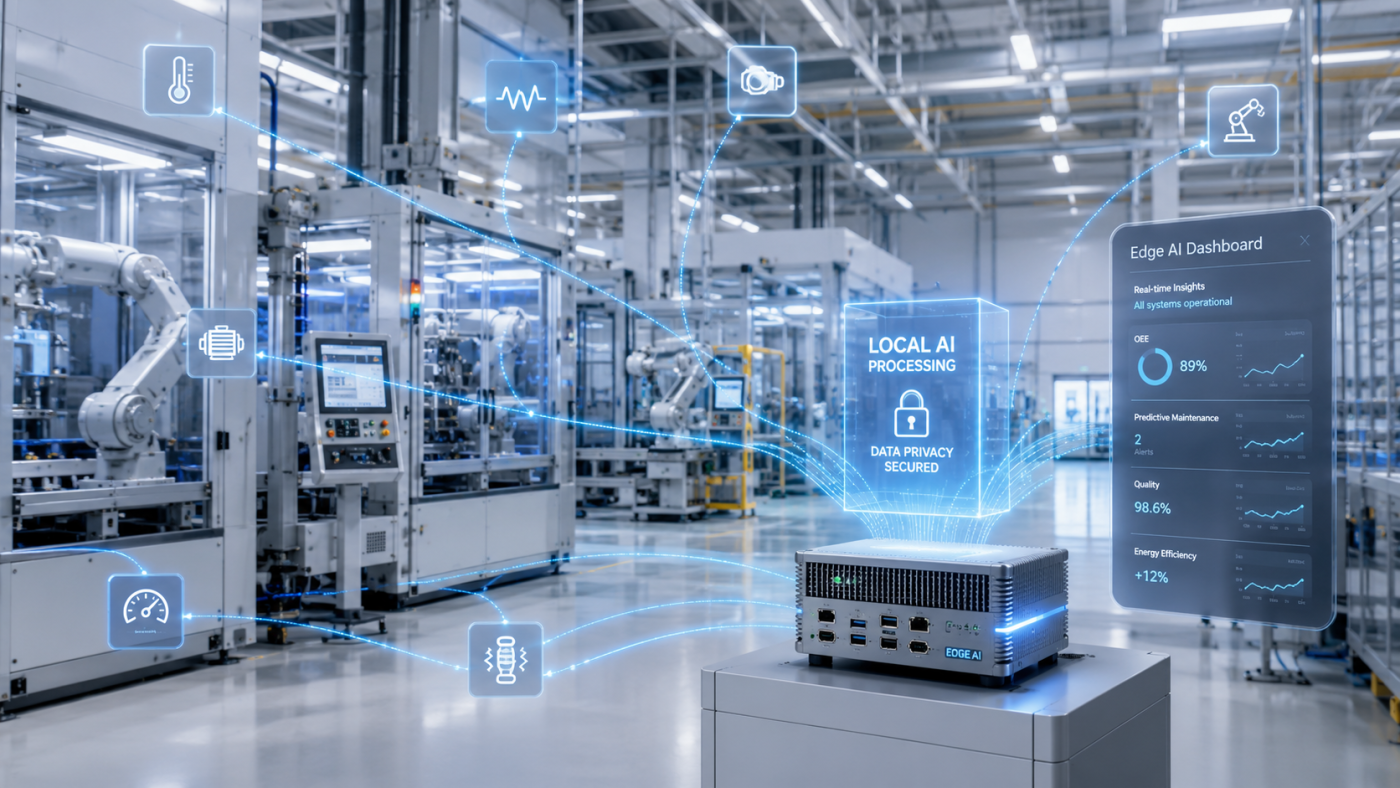
Qui possiamo usare dispositivi più capaci: Raspberry Pi, mini-PC industriali fanless, edge server locali, gateway su guida DIN o piccoli server interni.
Questo è il punto in cui i dati provenienti dai sensori vengono aggregati, normalizzati e trasformati in informazioni leggibili.
Qui ha senso introdurre modelli AI compatti.
Parliamo di modelli come Llama 3.2 1B/3B, Qwen2.5 1.5B/3B o Phi-3.5 mini. Meta ha presentato Llama 3.2 includendo modelli text-only da 1B e 3B pensati anche per dispositivi edge e mobile. Ollama rende disponibili versioni di Llama 3.2 con tag 1B e 3B, utilizzabili in locale.
Questi modelli non devono sostituire un PLC.
Non devono gestire blocchi di sicurezza.
Non devono comandare arresti di emergenza.
Non devono prendere decisioni real-time al millisecondo.
Quel dominio resta dei PLC, degli SCADA, dei controllori industriali e dei sistemi certificati.
Il compito di un modello compatto su edge gateway è diverso: leggere log, classificare eventi, interpretare anomalie, generare risposte strutturate, trasformare dati tecnici in indicazioni operative.
Esempio:
“Negli ultimi 12 cicli, la pressa ha mostrato una variazione progressiva nella curva di pressione rispetto allo storico. Il comportamento è ancora entro soglia, ma il trend suggerisce una possibile perdita di efficienza nell’impianto idraulico. Consigliata verifica preventiva prima del prossimo turno di produzione.”
Questo è il punto.
Non una dashboard piena di grafici da interpretare.
Ma un sistema capace di spiegare cosa sta succedendo.
Quale modello usare su Raspberry Pi o edge device
Per un Raspberry Pi o un piccolo gateway locale, la scelta del modello deve essere realistica.
Non serve inseguire il modello più grande. Serve un modello abbastanza leggero da girare bene, abbastanza stabile da rispondere in modo prevedibile e abbastanza disciplinato da produrre output utili.
Per classificazioni semplici, lettura di log e messaggi brevi, Llama 3.2 1B può essere una buona scelta. È leggero, rapido e adatto a task essenziali.
Per un Raspberry Pi 5 con RAM adeguata, Llama 3.2 3B può diventare un buon compromesso tra qualità e peso.
Se invece il sistema deve produrre output strutturati, per esempio JSON pulito da reinserire in un software gestionale o in una dashboard, Qwen2.5 1.5B o 3B può essere molto interessante. La famiglia Qwen2.5 è disponibile in taglie piccole come 0.5B, 1.5B e 3B su Ollama.
Phi-3.5 mini è un’altra opzione valida, soprattutto per task in cui serve più capacità di ragionamento sequenziale. Microsoft lo descrive come un modello leggero della famiglia Phi-3.5, con supporto a una context length fino a 128K token.
Ma su Raspberry Pi va usato con cautela.
Può essere interessante per test e prototipi, ma se il dispositivo deve anche raccogliere dati, gestire MQTT, scrivere su database, alimentare una dashboard e lavorare in modo continuo, un modello più piccolo può essere una scelta più prudente.
La logica corretta è questa:
TinyML sui microcontrollori.
LLM compatto sul gateway.
Python come orchestratore.
Cosa cambia per l'azienda
PLC e SCADA per sicurezza e controllo real-time.
Terzo livello: l’AI Agent locale
Il terzo livello è l’agente AI locale.
Qui il modello non lavora da solo.
Viene integrato con Python, database locali, MQTT, Modbus, API interne, dashboard, regole aziendali e storico dei dati.
Questo è il punto in cui il sistema smette di essere una semplice raccolta di segnali e diventa un vero assistente operativo.
L’agente può leggere gli eventi, confrontarli con lo storico, verificare le soglie, interrogare il database, consultare regole definite dall’azienda e generare una diagnosi.
Può produrre un alert tecnico.
Può generare un report di turno.
Può suggerire un controllo preventivo.
Può classificare un’anomalia.
Può spiegare perché un parametro è sospetto.
Tutto localmente.
Senza inviare dati sensibili nel cloud.
Senza dipendere dalla connessione internet.
Senza esporre informazioni industriali strategiche all’esterno.
Questa è una differenza sostanziale.
Perché non stiamo parlando di una AI generica che risponde a domande generiche. Stiamo parlando di un agente locale, addestrato o configurato per leggere il contesto operativo di un impianto specifico.
La catena corretta dell’AI industriale locale
Una buona architettura AI per IIoT potrebbe essere costruita così:
sensori → TinyML → edge gateway → modello compatto → agente locale → diagnosi operativa
Ogni livello ha un ruolo preciso.
I sensori raccolgono i dati.
Il TinyML intercetta pattern elementari vicino alla macchina.
Il gateway aggrega e normalizza.
Il modello compatto interpreta log, eventi e anomalie.
L’agente locale collega tutto e produce indicazioni comprensibili.
Il PLC continua a gestire il controllo real-time.
Questa separazione è fondamentale.
Perché un’architettura industriale credibile non deve confondere l’AI con l’automazione di sicurezza.
Metodo e prossimi passi
L’AI non deve sostituire ciò che già funziona e deve rimanere deterministico.
Deve aggiungere un livello superiore.
Un livello capace di leggere il comportamento dell’impianto nel tempo, individuare segnali deboli, rendere più chiari i dati e aiutare le persone a decidere meglio.
Perché questo approccio è più concreto del cloud AI generico
La promessa dell’AI industriale non è avere un chatbot in fabbrica.
La promessa reale è avere sistemi capaci di comprendere il contesto operativo.
Un sensore che rileva una vibrazione non basta.
Una dashboard che mostra venti grafici non basta.
Un allarme che scatta solo quando la soglia è già superata spesso arriva tardi.
Il valore emerge quando il sistema riesce a combinare più segnali: andamento storico, cicli macchina, temperature, assorbimenti, pressioni, qualità prodotto, manutenzioni precedenti, anomalie ricorrenti e condizioni operative.
A quel punto l’AI locale può trasformare un insieme frammentato di dati in una lettura comprensibile.
Non sostituisce il tecnico.
Gli fa vedere prima quello che normalmente vedrebbe troppo tardi.
Conclusione
L’Industrial IoT diventa davvero interessante quando l’intelligenza non è lontana, ma vicina alla macchina.
Dentro l’impianto.
Dentro l’azienda.
Sotto il controllo di chi quei dati li produce ogni giorno.
Il futuro dell’AI industriale non sarà fatto solo di enormi modelli cloud.
Sarà fatto anche di micro-modelli sui sensori, modelli compatti sui gateway, agenti locali orchestrati da Python e architetture distribuite capaci di lavorare offline.
Non modelli enormi ovunque.
Non cloud obbligatorio per ogni dato.
Non automazione raccontata come magia.
Ma una catena intelligente, concreta e sostenibile.
TinyML per rilevare.
Edge AI per interpretare.
Agenti locali per spiegare.
PLC e sistemi industriali per controllare.
Questa, secondo me, è una delle direzioni più solide dell’AI applicata all’industria.
Vuoi applicare l’AI alla tua azienda?
Partiamo da un caso d’uso concreto, misurabile e utile.
Possiamo analizzare processi, documenti e attività ripetitive per progettare una soluzione AI coerente con il tuo lavoro reale.